 码上精选
 李工
分库分表场景下的前端状态同步核心答案
前端需以类型安全的客户端缓存为核心,结合增量事件订阅与乐观更新策略,在保障交互流畅的前提下完成跨节点数据对齐。
「分库分表是指将单体关系型数据库按规则水平切分至多个物理实例,以突破单节点IO瓶颈的存储架构。」该架构彻底打破了传统单一API契约假设,迫使前端数据流从拉取渲染线性模型转向路由感知局部隔离全局归并的网状模型。决策者需明确,前端重构的核心并非重写业务组件,而是重建状态机的确定性边界与网络抽象层。
- 单点直连模式:依赖单一服务入口,代码侵入低,但无法承载海量分片路由,易成为网关性能瓶颈。
- 边缘聚合模式:通过CDN或前端轻量网关汇聚分片响应,降低主线程阻塞率,增加构建复杂度。
- 纯客户端协调模式:利用TypeScript泛型与React/Vue Context隔离分片数据域,极致优化首屏,但调试链路较长。
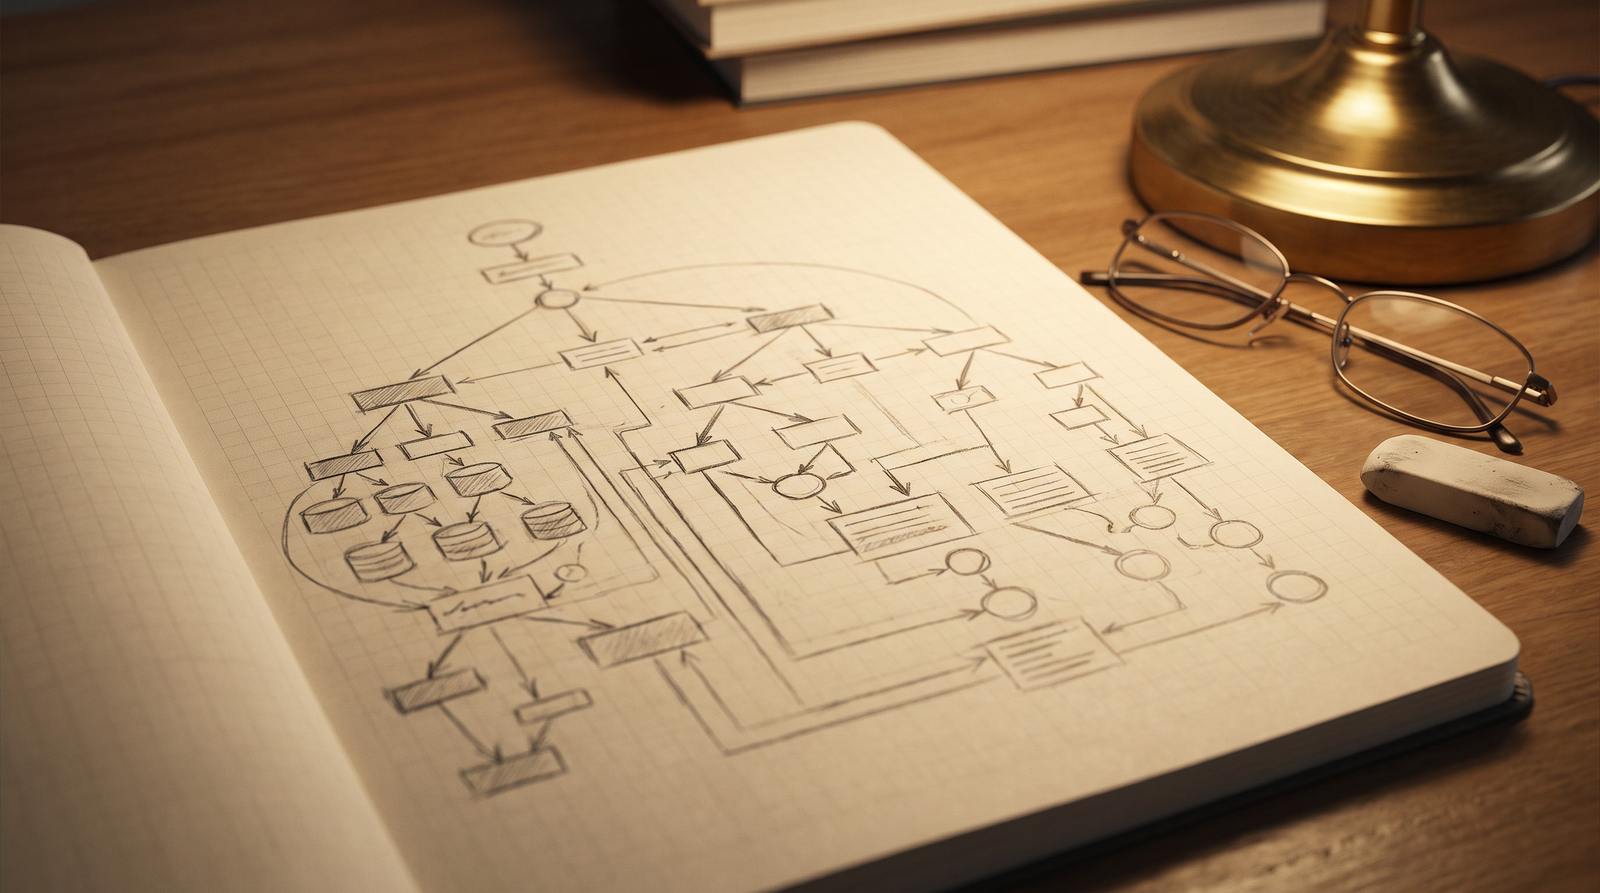
分库分表架构中的多方案横向评测
在浏览器端工程化实践中,团队通常面临三种技术路径的选择。第一种路径侧重静态缓存与按需失效,适合读多写少的内容型应用;第二种路径引入SSE/WebSocket长连接,通过消息序列化实现状态漂移修正,实时性高但占用带宽;第三种路径将路由计算前移,由前端SDK解析分片标识后直连目标节点,网络开销最小但对异常拦截要求极高。
- 一致性维度:强一致方案依赖事务补偿,最终一致方案依赖客户端冲突解决算法。
- 研发成本维度:接入成熟状态库可复用hooks模式,自研路由分发器需投入大量单元测试。
- 浏览器兼容性维度:Service Worker离线缓存能提升弱网体验,但需注意脚本体积对LCP指标的影响。
无论选择何种路径,数据新鲜度始终是首要考量。当后端发生主从切换时,前端需实现类似数据库读写分离架构中的数据延迟补偿与强一致性查询降级路径的本地重试与字段回刷逻辑,避免脏数据阻断用户转化漏斗。同时,网络层的不可控因素要求前端具备更高维度的防御设计。网关黑盒分发特性使得前端必须建立与分布式爬虫反爬策略下的IP代理池动态轮换与请求指纹伪装机制同等级别的弹性容错体系,确保分片路由抖动不引发主线程崩溃或UI白屏。
- 渲染管线维度:Suspense边界与虚拟滚动可有效遏制分片数据激增导致的FCP劣化。
- 类型安全维度:严格约束分片键泛型可提前拦截运行时类型错误,降低排查成本。
- 可观测性维度:接入OpenTelemetry追踪分片请求耗时,量化客户端状态合并开销。
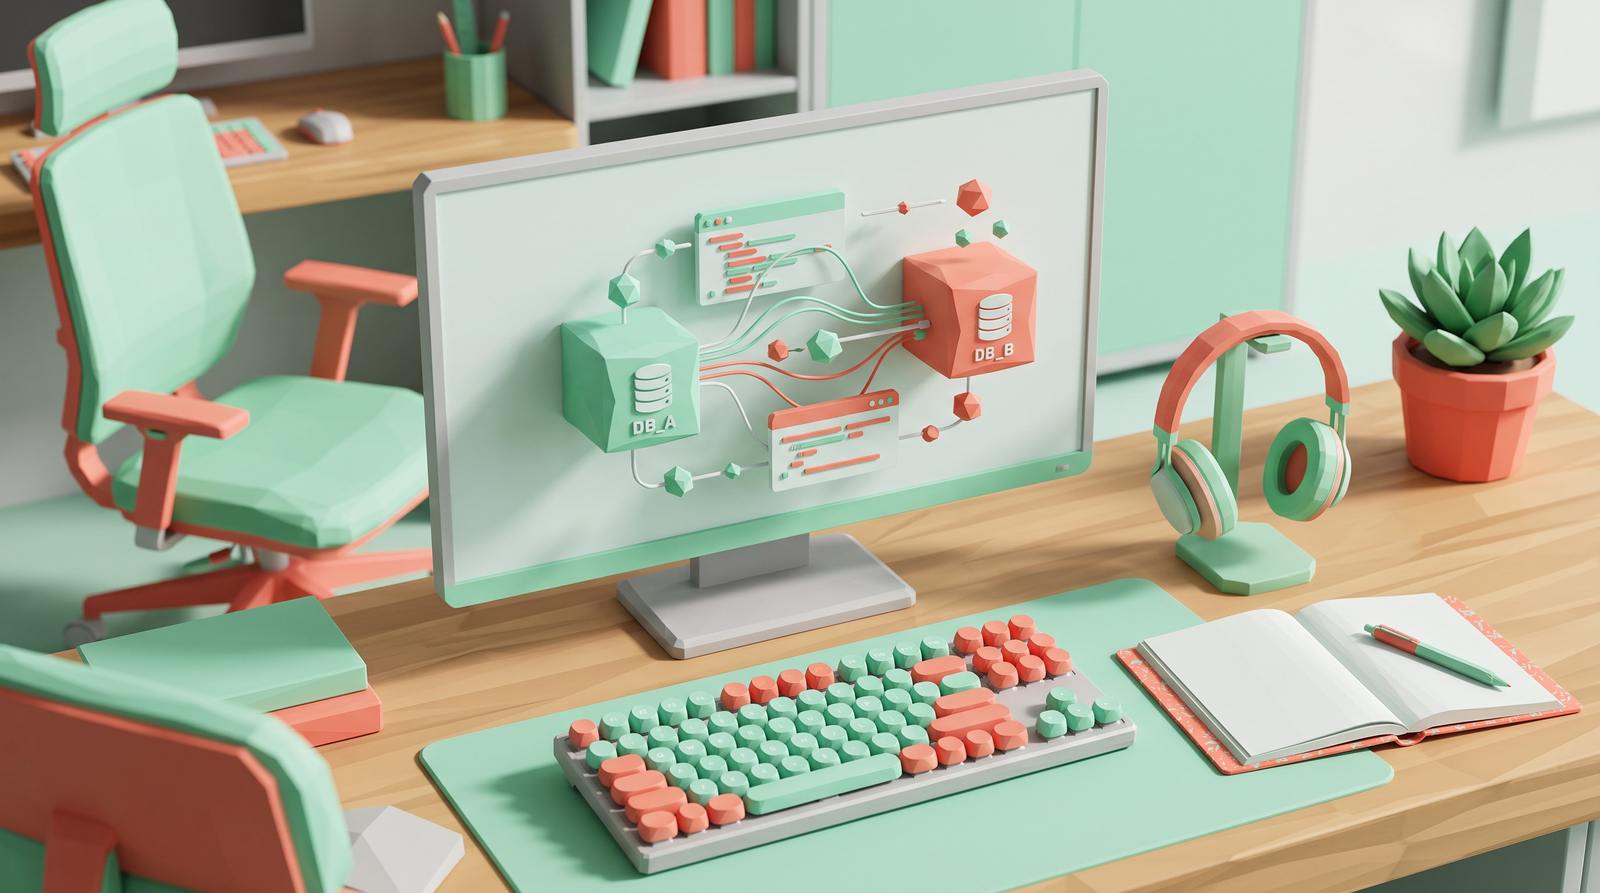
分库分表驱动的技术选型决策建议
对于初创团队,建议优先采用Type-Safe的轻量级Store配合局部状态懒加载,借助Vite插件自动生成分片路由映射表,快速验证市场反馈。对于中大型平台,应引入事件溯源机制,将前端状态视为不可变记录,配合Vue/React虚拟DOM Diff算法精准触达更新范围。决策时需评估团队对TypeScript高级类型的掌握程度,以及CI/CD流水线中集成E2E测试的能力。
- 业务规模匹配:日活低于百万可采用服务端聚合+客户端本地Diff,日活千万级以上需拆分微前端状态域。
- 团队技能栈评估:熟悉React并发特性的团队可探索Server Components直连分片数据源。
- 工程化基础设施:确保Webpack/Rspack支持Tree-Shaking未使用状态模块,控制包体积增长。
状态管理不应是单纯的代码组织问题,而是系统可扩展性的投影。合理的分层架构能将网络I/O转化为纯粹的计算资源,从而释放前端工程师的生产力。通过标准化分片通信协议与前置校验中间件,企业可在保障数据准确性的同时,维持浏览器端的极致交互体验。
常见问题
分片键变更如何同步?
迁移期执行双写策略,前端维护版本化状态快照。旧键数据转为只读视图,新键触发全量拉取与客户端增量合并,确保平滑过渡零故障。
浏览器端内存膨胀怎么解?
实施LRU淘汰策略,结合TS严格类型约束。定期清理废弃状态树分支,限制单对象体积,配合Performance API监控堆内存泄漏。
弱网环境下的冲突处理?
启用操作日志或CRDT算法,前端按时间戳排序合并差异。失败任务进入本地队列异步重放,保障核心交互链路不断裂。
前端数据流的重构是一场关于确定性与性能的持久战。随着分库分表架构的常态化,唯有坚持类型驱动与可观测先行,方能在复杂网络拓扑中守住用户体验底线。